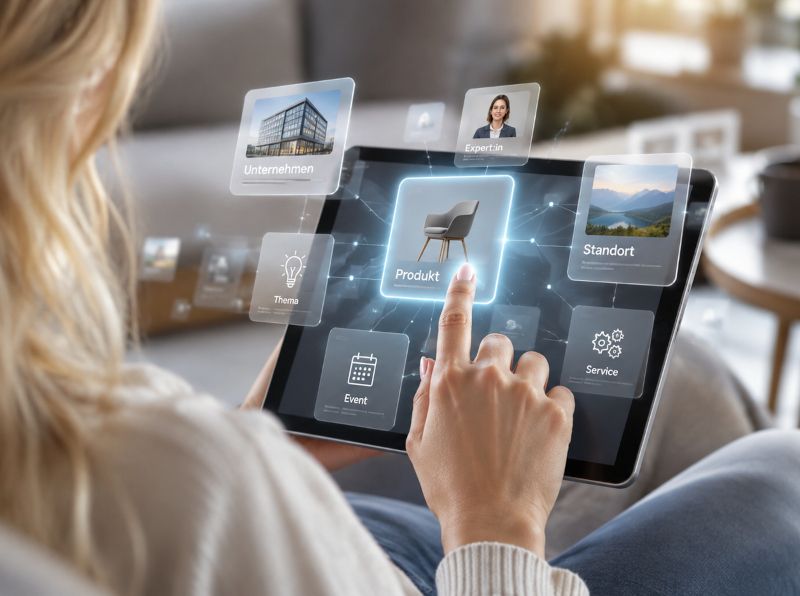
Wir erkennen beispielsweise, dass ein Unternehmen Marketing-Automation anbietet, mit n8n arbeitet, Fachartikel darüber veröffentlicht und entsprechende Projekte umgesetzt hat. Daraus schließen wir: Die kennen sich offenbar mit diesem Thema aus.
Suchmaschinen und KI-Systeme müssen solche Zusammenhänge dagegen aus Informationen ableiten. Sie müssen erkennen, worum es geht, wer hinter einem Inhalt steht und wie Personen, Unternehmen, Leistungen, Themen und Inhalte miteinander verbunden sind.
Und genau deshalb könnte sich gerade eine grundlegende Regel digitaler Sichtbarkeit verändern: Nicht nur einzelne Seiten und Keywords werden wichtig, sondern das Wissensnetz, das hinter einer Website entsteht.
Langfristig könnte diese Entwicklung sogar verändern, was wir heute überhaupt unter einer Website verstehen.
Von Keywords zu Entitäten: Was verändert sich?
Stellen wir uns eine Schreinerei vor, die sich auf nachhaltige Massivholzküchen spezialisiert hat.
Jemand fragt eine KI: „Wer baut nachhaltige Massivholzküchen im Raum München?“
Auf der Website der Schreinerei finden sich eine Leistungsseite über Küchenbau, Artikel über regionale Holzarten, Referenzprojekte mit Massivholzküchen und ein Porträt der Schreinermeisterin, die seit 15 Jahren mit heimischen Hölzern arbeitet.
Für einen Menschen ergibt sich daraus schnell ein Bild: Diese Schreinerei scheint genau darauf spezialisiert zu sein. Für Maschinen sind die dahinterliegenden Beziehungen interessant:
Schreinerei → bietet Küchenbau → verwendet Massivholz → arbeitet mit regionalen Hölzern → beschäftigt Schreinermeisterin → veröffentlicht Fachwissen → zeigt entsprechende Referenzprojekte.
Aus einzelnen Seiten entsteht damit ein zusammenhängendes Bild darüber, wer dieses Unternehmen ist und wofür es Expertise besitzt.
Hier kommen Entitäten ins Spiel.
Eine Entität ist zunächst nichts Mystisches. Sie ist ein eindeutig identifizierbares „Ding“ – beispielsweise ein Unternehmen, eine Person, ein Produkt, eine Dienstleistung, ein Ort, eine Technologie oder ein Thema.
Interessant wird es durch die Beziehungen zwischen diesen Entitäten:
- ein Unternehmen bietet eine Leistung an,
- eine Person besitzt Expertise zu einem Thema,
- ein Artikel wurde von dieser Person geschrieben,
- dieser Artikel behandelt eine bestimmte Technologie,
- eine Referenz dokumentiert Erfahrung mit dieser Technologie,
- mehrere Inhalte gehören zum selben Themengebiet.
Aus einzelnen Informationen entsteht dadurch ein Wissensnetz. Je klarer diese Beziehungen sind, desto leichter können Menschen und Maschinen einordnen, wer oder was bei einem bestimmten Thema relevant ist.
Keywords, Entitäten und GEO: Wo liegt der Unterschied?
Die Begriffe werden derzeit häufig vermischt, beschreiben aber unterschiedliche Ebenen.
Keywords helfen dabei zu verstehen, wonach Menschen suchen. Klassische SEO beschäftigt sich deshalb unter anderem mit Suchintentionen, relevanten Suchbegriffen, Content, interner Verlinkung und den technischen Voraussetzungen dafür, dass Inhalte gefunden und indexiert werden können.
Entitäten beschreiben dagegen, worum oder um wen es eigentlich geht. Ein Begriff wie „Apple“ ist zunächst nur eine Zeichenfolge. Erst durch Kontext und Beziehungen wird eindeutig, ob das Technologieunternehmen, die Frucht oder etwas anderes gemeint ist.
GEO – Generative Engine Optimization – erweitert diese Perspektive auf generative Such- und Antwortsysteme. Dort geht es nicht mehr ausschließlich darum, mit einer bestimmten URL möglichst weit oben in einer Ergebnisliste zu erscheinen. Interessant wird auch, ob Informationen so eindeutig, zugänglich und nachvollziehbar sind, dass generative Systeme sie verstehen, zuordnen und gegebenenfalls als Quelle verwenden können.
SEO verschwindet dadurch nicht. Die Perspektive wird größer.
SEO fragt: Welche Inhalte beantworten eine Suchintention?
Entity-orientiertes Denken fragt zusätzlich: Welche Personen, Unternehmen, Leistungen und Themen stehen hinter diesen Inhalten und wie hängen sie zusammen?
GEO fragt: Können generative Systeme diese Informationen eindeutig verstehen, einordnen und verwerten?
Diese Bereiche konkurrieren also nicht miteinander. Sie ergänzen sich.
Warum mehr Content nicht automatisch mehr Sichtbarkeit bedeutet
Die Antwort vieler Unternehmen auf den steigenden Wettbewerb um digitale Sichtbarkeit lautet: mehr Content. Mit generativer KI ist es inzwischen einfacher denn je, innerhalb kurzer Zeit große Mengen davon zu produzieren. Genau darin liegt allerdings auch das Problem.
30 Artikel ergeben zunächst einmal nur 30 Artikel.
Wenn ein Unternehmen heute über KI schreibt, morgen über Social Media, übermorgen über Nachhaltigkeit und nächste Woche über zehn weitere Trendthemen, entsteht viel Content, aber nicht zwangsläufig ein klares fachliches Profil.
Interessanter wird Content, wenn er systematisch um bestimmte Kompetenzfelder aufgebaut wird. Rund um Marketing-Automation könnten beispielsweise Inhalte über n8n, automatisierte Lead-Prozesse, CRM-Integrationen, KI-Agenten, APIs und konkrete Automatisierungsprojekte entstehen.
Diese Inhalte sind miteinander verbunden, gehören zu einer klar definierten Leistung, stammen von identifizierbaren Autoren und werden durch passende Referenzen ergänzt.
So entsteht nach und nach ein konsistentes Bild darüber, wer bei welchem Thema wofür steht.
Der Unterschied ist entscheidend:
Content-Menge erzeugt noch keine Bedeutung. Beziehungen erzeugen Bedeutung.
Gerade weil KI inzwischen problemlos große Mengen durchschnittlichen Contents produzieren kann, könnten fachliche Tiefe, nachvollziehbare Expertise und eine konsistente Informationsstruktur künftig sogar wichtiger werden.
Von einzelnen Seiten zum digitalen Wissensnetz
Damit verändert sich auch die Art, wie wir Websites konzipieren können.
Traditionell denken wir stark von der späteren Darstellung aus. Wir benötigen eine Leistungsseite, also erstellen wir eine Seite und schreiben dort die Informationen hinein. Wir benötigen einen Artikel, also legen wir eine Artikelseite an.
Technisch müssen Inhalte aber nicht zwangsläufig so organisiert sein.
Eine Leistung kann beispielsweise als eigenständiges Informationsobjekt existieren und Beziehungen zu Fachartikeln, Technologien, Ansprechpartnern, Branchen und Referenzen besitzen. Ein Fachartikel wiederum kennt seinen Autor, seine Themen, die darin behandelten Technologien und verwandte Leistungen.
Hinter der sichtbaren Website entsteht dadurch eine Informationsstruktur:
Unternehmen → Leistungen → Themen → Personen → Artikel → Technologien → Referenzen
Die sichtbaren Seiten sind dann nicht mehr die eigentliche Informationsstruktur. Sie sind eine Darstellung dieser Struktur.
Und genau an diesem Punkt wird die Entwicklung besonders interessant.
Was, wenn die Website künftig keine feste Oberfläche mehr hat?
Heute entscheidet normalerweise ein Webdesigner oder Entwickler, welche Inhalte ein Besucher auf einer bestimmten Seite sieht. Jeder Besucher bekommt im Wesentlichen dieselbe Informationsarchitektur präsentiert.
Das muss nicht zwangsläufig so bleiben.
Wenn Inhalte unabhängig von ihrer Darstellung strukturiert gespeichert und miteinander verbunden sind, kann eine Benutzeroberfläche theoretisch immer stärker situationsabhängig daraus zusammengesetzt werden.
Ein Geschäftsführer, der sich für Prozessautomatisierung interessiert, könnte andere Inhalte und Zusammenhänge benötigen als eine Marketingmanagerin, die nach einer automatisierten Content-Pipeline sucht. Ein Mensch möchte vielleicht eine klassische Leistungsseite lesen. Ein anderer stellt seine Frage direkt an einen KI-Assistenten. Ein dritter nutzt Sprache statt Navigation.
Die zugrunde liegenden Informationen können dieselben sein.
Die Benutzeroberfläche wird variabel. Das Wissen dahinter bleibt strukturiert.
Das bedeutet nicht, dass klassische Websites morgen verschwinden. Sie bleiben Markenraum, Informationsquelle, Vertrauensanker und Benutzeroberfläche für Menschen.
Aber die Website könnte zunehmend eine von mehreren möglichen Oberflächen auf demselben Informationsbestand werden.
Neben ihr können Suchmaschinen, Apps, Sprachinterfaces, KI-Assistenten oder Agenten auf dieselben Informationen zugreifen.
Damit verschiebt sich der Schwerpunkt: Wir bauen nicht mehr nur Seiten. Wir bauen zunehmend Informationssysteme, aus denen unterschiedliche Interfaces entstehen können.
Warum Content-Management dadurch strategisch wird
Spätestens hier stellt sich eine technische Frage: Wie verwaltet man Content, wenn er nicht mehr ausschließlich zu einer bestimmten Seite gehört?
Genau deshalb halte ich strukturiertes Content-Management für einen wichtigen Bestandteil dieser Entwicklung.
In vielen klassischen Websites steckt eine Information direkt in einem Seiteninhalt. Eine Leistung wird beispielsweise in einem Text beschrieben und zusätzlich vielleicht noch einmal in einem Blogartikel, einer Referenz und auf der Startseite erwähnt.
Das funktioniert – erzeugt aber schnell redundante und voneinander unabhängige Informationen.
Ein strukturiertes Content-Modell geht anders vor. Statt ausschließlich Seiten zu verwalten, werden die tatsächlichen Bestandteile des Unternehmens modelliert.
Zum Beispiel:
- Leistungen wie Marketing-Automation oder Webentwicklung,
- Personen und ihre Fachgebiete,
- Themen wie GEO, n8n oder digitale Barrierefreiheit,
- Technologien und eingesetzte Systeme,
- Artikel und Fachinhalte,
- Referenzen und Projekte,
- Unternehmen, Marken und Partner.
Diese Inhalte bekommen anschließend definierte Beziehungen zueinander.
Ein Artikel behandelt beispielsweise GEO, gehört zu einem bestimmten Kompetenzfeld, wurde von einer bestimmten Person geschrieben und verweist auf eine passende Leistung. Eine Referenz kann wiederum mit dieser Leistung, einer Branche und mehreren Technologien verbunden sein.
Aus Content-Management wird damit zunehmend Informationsmanagement.
Was ein Headless CMS dabei anders macht
Genau hier wird ein Headless CMS interessant.
Bleiben wir bei unserer Schreinerei, die sich auf individuelle Massivholzküchen spezialisiert hat. Auf einer klassischen Website könnte die Information „Massivholzküche“ an vielen verschiedenen Stellen auftauchen: auf der Leistungsseite für Küchenbau, in einem Artikel über nachhaltige Küchen, in mehreren Referenzprojekten oder auf einer Seite über verwendete Materialien.
Für Menschen ist der Zusammenhang meist offensichtlich. Technisch betrachtet sind es aber zunächst voneinander unabhängige Inhalte.
Bei einem Headless CMS lassen sich Inhalt und Darstellung konsequenter voneinander trennen. Das CMS verwaltet strukturierte Informationen und deren Beziehungen. Das Frontend – beispielsweise eine mit Nuxt entwickelte Website – entscheidet anschließend, wie und in welchem Kontext diese Informationen dargestellt werden.
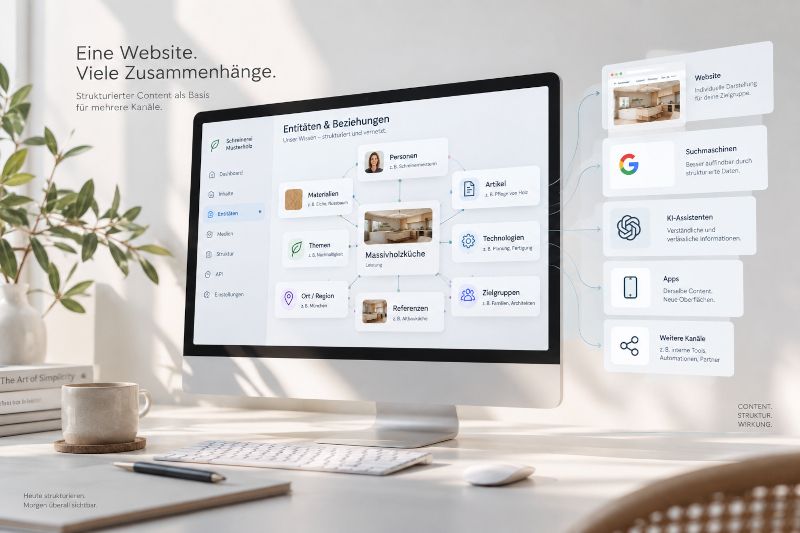
Eine Massivholzküche ist damit nicht mehr nur ein Begriff, der auf verschiedenen Seiten in Texten vorkommt. Sie kann als eigenständige Entität im Content-Modell existieren.
Vereinfacht könnte das beispielsweise so aussehen:
Massivholzküche
→ Typ: Leistung / Produktbereich
→ angeboten von: Schreinerei Musterholz
→ Materialien: Eiche, Buche, Nussbaum
→ Thema: nachhaltiger Küchenbau
→ passende Fachartikel: Pflege von Massivholz, regionale Holzarten, nachhaltige Küchenplanung
→ Referenzen: Altbauküche München, Familienküche Starnberg
→ Ansprechpartner: Schreinermeisterin Anna Muster
→ Region: München und Umgebung
Der entscheidende Unterschied: Diese Zusammenhänge werden nicht nur irgendwo in einem Fließtext erwähnt. Sie existieren als Datenstruktur. Und genau damit lässt sich technisch arbeiten.
Was sich mit strukturiertem Content technisch umsetzen lässt
Ein solches Content-Modell eröffnet wesentlich mehr Möglichkeiten als eine Sammlung voneinander unabhängiger Seiten.
Besucht jemand die Seite über Massivholzküchen, können dort beispielsweise automatisch passende Referenzprojekte, verwendete Holzarten und Fachartikel angezeigt werden. Auf der Seite zur Holzart Eiche können wiederum Küchenprojekte erscheinen, bei denen Eiche tatsächlich eingesetzt wurde. Das Profil der Schreinermeisterin kann automatisch ihre Fachartikel, Projekte und Kompetenzbereiche bündeln.
Die Zusammenhänge müssen nicht auf jeder Seite erneut manuell gepflegt werden. Sie entstehen aus den Beziehungen im Content-Modell.
Das wird besonders interessant, wenn sich die Benutzeroberfläche künftig stärker an Kontext und Informationsbedarf anpasst.
Sucht jemand nach einer „nachhaltigen Küche aus regionalem Holz“, könnten Inhalte zu Holzherkunft, Nachhaltigkeit und entsprechenden Referenzprojekten besonders relevant sein.
Interessiert sich jemand dagegen für eine „Massivholzküche für einen kleinen Altbau“, werden möglicherweise Altbauprojekte, individuelle Maßanfertigungen und platzsparende Lösungen wichtiger.
Die zugrunde liegenden Informationen bleiben dieselben. Nur ihre Zusammenstellung und Darstellung verändert sich.
Genau darin liegt einer der großen Vorteile von strukturiertem Content: Das Wissen ist nicht fest an eine einzelne Benutzeroberfläche gebunden.
Und Maschinen können die Zusammenhänge ebenfalls nutzen
Auch die Maschinenlesbarkeit lässt sich auf dieser Grundlage systematischer aufbauen.
Informationen aus dem CMS können beispielsweise genutzt werden, um strukturierte Daten zu erzeugen. Unternehmen, Personen, Artikel, Leistungen, Produkte oder andere Entitäten lassen sich mit Schema.org beschreiben und miteinander verknüpfen.
Die Schreinermeisterin ist dann nicht nur ein Name in einem Text. Sie kann als Person beschrieben und mit der Schreinerei, ihren Artikeln und ihren Fachgebieten verbunden werden.
Das Referenzprojekt ist nicht nur eine Unterseite mit schönen Bildern. Es besitzt Beziehungen zu einer Leistung, einem Ort, verwendeten Materialien und möglicherweise einer verantwortlichen Person.
Und die Massivholzküche ist nicht nur ein Keyword, das möglichst häufig in einem Text vorkommt, sondern Teil eines größeren semantischen Zusammenhangs.
Idealerweise basiert damit das, was Menschen auf der Website sehen, und das, was Maschinen über das Unternehmen erfahren können, auf derselben strukturierten Informationsquelle.
Eine Wissensbasis, verschiedene Oberflächen
Über APIs können dieselben Informationen außerdem an weitere Systeme ausgeliefert werden.
Heute ist das vielleicht hauptsächlich die Website. Dieselbe Wissensbasis könnte aber auch eine interne Suche, eine App, einen Produktberater oder eine Automation versorgen. Perspektivisch können auch KI-Anwendungen, Sprachinterfaces oder Agenten auf strukturierte Informationen zugreifen.
Vereinfacht entsteht folgende Architektur:
Headless CMS
↓
Schreinerei · Leistungen · Personen · Materialien · Themen · Artikel · Referenzen
↓
Entitäten + Beziehungen
↓
API / Content Layer
↓
Website · strukturierte Daten · Suche · Apps · Automationen · KI-Systeme
Genau deshalb sehe ich Headless nicht einfach als eine alternative CMS-Technologie.
Es ermöglicht, Content unabhängig von seiner heutigen Benutzeroberfläche zu organisieren.
Die Website wird damit zu einer möglichen Darstellung des Wissens – aber das Wissen selbst ist nicht mehr in einzelnen Webseiten eingeschlossen.
Ist deine Website darauf vorbereitet? Ein kurzer Check
Nicht jedes Unternehmen braucht deshalb sofort ein neues CMS oder einen eigenen Knowledge Graph. Die grundlegende Denkweise ist aber auch für kleinere Websites sinnvoll.
Ein einfacher Check:
✓ Sind Unternehmen, Personen, Leistungen, Produkte und wichtige Themen eindeutig beschrieben?
✓ Gibt es zu den zentralen Kompetenzfeldern echte fachliche Tiefe statt vieler isolierter Einzelartikel?
✓ Sind Leistungen, Artikel, Autoren, Produkte, Materialien oder Referenzen logisch miteinander verbunden?
✓ Spiegelt die interne Verlinkung diese Beziehungen wider?
✓ Werden relevante Informationen über strukturierte Daten zusätzlich maschinenlesbar ausgezeichnet?
✓ Sind die Inhalte technisch sauber und semantisch aufgebaut?
✓ Können wichtige Inhalte unabhängig von einer bestimmten Seite verwendet werden?
✓ Ist das Content-Modell flexibel genug, um dieselben Informationen künftig auch an andere Systeme auszuliefern?
Je häufiger die Antwort „nein“ lautet, desto stärker steckt das digitale Wissen wahrscheinlich noch in einzelnen Seiten fest.
Fazit: Die Website wird zur Oberfläche eines Wissenssystems
Websites werden nicht verschwinden, nur weil Menschen zunehmend KI-Systeme für ihre Suche verwenden. Aber ihre Rolle verändert sich.
Unsere Schreinerei wird auch künftig eine Website brauchen. Menschen möchten Küchen sehen, Referenzprojekte betrachten, etwas über das Unternehmen erfahren und entscheiden, ob sie ihm ihr Projekt anvertrauen möchten.
Aber hinter dieser sichtbaren Website kann mehr entstehen: ein strukturiertes digitales Wissenssystem über das Unternehmen.
Die Massivholzküche ist darin mit Materialien verbunden. Materialien mit Fachartikeln. Artikel mit Autoren. Autoren mit Expertise. Referenzen mit Leistungen, Materialien und Orten. Und all diese Informationen führen wieder zum Unternehmen zurück.
SEO hilft dabei, relevante Inhalte auffindbar zu machen. GEO erweitert diese Perspektive auf generative Systeme. Entitäten schaffen Eindeutigkeit. Content erzeugt Kontext und fachliche Tiefe. Strukturierte Daten machen wichtige Zusammenhänge maschinenlesbar. Und modernes Content-Management sorgt dafür, dass dieses Wissen nicht in einzelnen Seiten eingesperrt bleibt.
Genau dort treffen Content-Strategie und moderne Webentwicklung aufeinander.
Vielleicht lautet die entscheidende Frage deshalb künftig nicht mehr nur:
„Wie bauen wir die perfekte Website?“
Sondern:
„Wie strukturieren wir unser digitales Wissen so, dass Menschen, Suchmaschinen und KI-Systeme damit arbeiten können?“
Die Website der Zukunft wäre dann keine starre Sammlung einzelner Seiten.
Sie wäre eine flexible Benutzeroberfläche auf einem vernetzten Wissenssystem.